Premessa
I contenuti che discuto in questo articolo mi sono stati segnalati da utenti che mi seguono (e che ringrazio), e ho potuto accedervi, ma non commentare, tramite un account Instagram secondario. In questo articolo verranno sempre commentati i testi originali, direttamente con immagini o screenshot, oppure riportando i testi come citazione per facilitare la lettura. Nell’ultimo caso, eventuali tagli segnalati da [...] riguardano sempre brevi frasi riempitive la cui assenza non compromette il significato generale del commento.
La mia pagina Instagram NoTrueFeminist è tuttora sottoposta a un blocco da parte di alcuni dei personaggi citati. In particolare, non mi è possibile commentare i post di uomini.in.ascolto, e Manolo Farci mi ha bloccato verso fine settembre per una questione legata alle critiche all’antisessismo che lui, Leonardo Laviola e altri portano avanti da inizio 2026, di cui i fatti che sto per commentare sono soltanto l’ultimo episodio.
Questo articolo è da intendersi come una raccolta di repliche e considerazioni sulle vicende nate a seguito della pubblicazione della mia recensione critica di un paper di Manolo Farci e Nicola Righetti, “Italian men’s rights activism and online backlash against feminism”, che ho radunato in un unico testo sia per evitare di rispondere qua e là in modo frammentato, sia appunto perché rispondere sotto al carosello in questione o direttamente con le persone interessate non mi è di fatto possibile. Per lo stesso motivo, se in futuro dovessero emergere altre critiche o risposte, le aggiungerò qui in calce, con la relativa data, invece di scrivere un nuovo articolo.
Cronologia essenziale
- 9 ottobre 2026: la pagina Instagram uomini.in.ascolto pubblica un post in collaborazione con Manolo Farci, professore di Sociologia presso UniUrb e studioso di fenomeni vicini alla cosiddetta manosfera, ovvero l’insieme dei gruppi maschili online. Il carosello è l’ultimo di una serie di critiche arrivate da inizio 2026 al neonato “Movimento Antisessista Italiano”, e rimarca la presunta sovrapposizione ideologica appunto tra l’antisessismo e l’antifemminismo degli MRA (Men’s Right Activists). Tra le tre fonti citate a sostegno, risulta un paper del 2019 di cui Farci è co-autore [Farci e Righetti 2019].
-
12 ottobre: in risposta al suddetto post, pubblico sulla pagina Instagram di NoTrueFeminist un carosello di analisi approfondita dell’articolo di Farci & Righetti, in contemporanea a un articolo sul presente blog. Avevo già letto questo paper alcuni mesi prima, trattandosi della fonte che veniva citata quasi sempre ogni volta che qualcuno su Instagram sollevava una critica all’antisessismo; i circa 3 giorni intercorsi tra i due caroselli, dunque, sono stati da me spesi per riordinare gli appunti presi in fase di lettura e scrivere l’articolo per il blog (come avevo anticipato in una story del 10 ottobre, era un post che avevo in mente da un po’). Come sono solita fare, e come ho dichiarato in varie occasioni, ho poi generato i testi per le slide del carosello aiutandomi con Claude a partire dall’articolo stesso, in modo da riassumerne il contenuto in modo compatto ed efficace, ovvero più appropriato per un pubblico social.
-
12-13 ottobre: in seguito ad alcuni commenti ricevuti principalmente tra Instagram e Facebook, ho apportato alcune correzioni minori all’articolo del blog. Essendo il carosello Instagram non più modificabile dopo la pubblicazione, ho condiviso tali modifiche aggiungendo un “EDIT” al post e un paio di storie esplicative.
-
14 ottobre: Manolo Farci, stavolta in collaborazione con Leonardo Laviola (anche lui già autore di numerose critiche all’antisessismo nei mesi passati), pubblica una risposta alla mia analisi. Lo stesso giorno mi viene segnalato un ulteriore articolo, pubblicato da Donata Columbro, in cui si parla, oltre che della faccenda, anche della mia recensione a un altro paper a cui lei aveva dedicato un articolo con intervista allo stesso Farci. Entrambi saranno oggetto di alcune considerazioni nel presente articolo.
Qual era il mio obiettivo
Ho già esplicitato tale obiettivo nell’introduzione dell’articolo, ma lo riassumo brevemente: Italian men’s rights activism and online backlash against feminism è un paper che viene regolarmente citato a supporto delle crescenti accuse di antifemminismo e misoginia al movimento antisessista.
Il paper ricostruisce una rete di 46 pagine Facebook italiane sui temi maschili, partendo dalla pagina Antisessismo, e ne analizza post e commenti fino ad aprile 2019. Gli autori individuano due filoni: uno legato a separazioni e violenza sugli uomini, più conservatore, e uno “antisessista”, che usa un lessico egualitario ma viene letto come una forma più sofisticata di antifemminismo e come possibile porta d’ingresso verso incel e MGTOW. Nelle conclusioni, il paper propone di riconoscere la vittimizzazione maschile e di aprire un dialogo con i membri moderati.
Il mio desiderio di leggere e commentare l’articolo è nato indubbiamente da una motivazione personale, riconoscendomi io nei principi del movimento antisessista. Leggendo il paper mi aspettavo di trovare un legame debole tra la rete MRA del 2019 e l’antisessismo di oggi, e così è stato. Mi sono però accorta che il paper non dimostra nemmeno che quella rete fosse antifemminista nel senso di ostile alle donne, cioè misogina: gli stessi autori scrivono che il filone antisessista era orientato «più contro le femministe che contro le donne», e il passaggio dalla critica al femminismo alla misoginia viene affermato senza essere mostrato nei dati.
Il carosello di “risposta” alla mia recensione di Farci & Righetti 2019
Ero abbastanza curiosa di leggere la risposta di Farci alla mia analisi, che non si è fatta attendere. Sfortunatamente però non si è rivelata una vera e propria risposta alle mie critiche, bensì un connubio di accuse ingiustificate e di aspetti che non c’entrano, e una replica ai punti da me sollevati non si è vista, almeno inizialmente.
La caption di accompagnamento al carosello riassume ciò di cui parlerà:
Quando l’intelligenza artificiale incontra l’attivismo, c’è il rischio che la critica scientifica venga utilizzata come strumento di delegittimazione
Una prima criticità consiste nel fatto che il post non contiene nessun riferimento a me o al mio carosello, di fatto impedendo a chiunque non lo conoscesse già di farsi un’idea indipendente.
Procedo comunque a commentare uno per uno i punti salienti della replica, a cominciare dal titolo.
“Aiuto, mi hanno hackerato la ricerca!!”
Non sono riuscita a trovare un senso, letterale o figurato che sia, a questo titolo, se non il tentativo dell’autore di fare una battuta strafottente ma che, almeno a me che sono informatica, non fa che mostrare quanta poca familiarità l’autore abbia col concetto di “hacking”, o in alternativa che ritenga di aver subito un attacco, dimostrando in questo caso di aver frainteso (o ignorato) l’obiettivo della mia critica.
“Peer review”
Pare che un mio articolo scientifico […] sia stato recentemente sottoposto a una nuova peer review.
Penso sia chiaro a chiunque che la mia recensione non fosse una peer review, anche perché non è mai stata presentata come tale: la “revisione paritaria” è quel processo tramite il quale un lavoro viene valutato in modo critico da parte di specialisti che hanno competenze analoghe agli autori dell’opera in questione. I requisiti minimi per parlare di peer review, insomma, sono che avvenga di norma prima della pubblicazione, ad esempio su una rivista scientifica, e soprattutto che chi fa la revisione sia un peer, ovvero un collega specializzato nella materia del lavoro che si sta discutendo.
In un certo senso mi lusinga che la mia recensione venga introdotta nel discorso come un lavoro di peer review, anche se poi, come diventa evidente leggendo il resto del carosello, viene trattata in tutt’altro modo. Resta però il fatto, come già scritto, che non mi sia mai spacciata per qualcuno che non sono, ovvero un’esperta della materia. Ho infatti letto il paper come “privata cittadina” che si interessa di questi temi, adoperando lo stesso spirito critico che riservo a qualunque lettura (comprese quelle con cui tendenzialmente sono d’accordo).
Se dunque definirla una “nuova peer review” era a mo’ di presa in giro sarcastica, mi duole dire che non aveva senso di essere.
“Account anonimo”
Questa volta, però, da un account anonimo su Instagram.
Il mio cognome non è pubblico, ma il mio nome sì; chiunque mi segua da un minimo di tempo può testimoniare di avere a che fare con una persona in carne e ossa. Soprattutto, ho partecipato a due live (1 e 2) in cui mi si vede in faccia.
Chi volesse insistere sul fatto che chi scrive è un profilo anonimo pur di minare la mia credibilità sarebbe ovviamente libero di farlo, ma sappia che in pratica sta dichiarando di attaccarsi al presunto anonimato dal momento che non ha nessuna argomentazione migliore a disposizione.
“Non possiede gli strumenti”
Premesso che la critica scientifica è sempre benvenuta, ci sono almeno due condizioni che ritengo fondamentali affinché la possa accettare: la prima è possedere gli strumenti necessari per comprendere e utilizzare correttamente i concetti metodologici che si chiamano in causa; la seconda, ancora più importante, è criticare ciò che gli autori hanno effettivamente scritto, non ciò che si vorrebbe avessero scritto. Due condizioni che, in questo caso, non mi sembra siano state sempre rispettate.
Mi trovo tutto sommato d’accordo su entrambi i requisiti. L’unico problema è che in tutto il carosello (e neanche nei commenti pubblicati successivamente) non venga fornito, a parte l’esempio sulla saturazione di cui parlo più avanti, il minimo elemento a sostegno che la sottoscritta non abbia gli strumenti per comprendere e utilizzare i concetti metodologici, né tantomeno che abbia attribuito agli autori qualcosa che non è stato scritto nel paper.
Per questo, nonostante possa farlo, ritengo sia inutile replicare punto per punto alle obiezioni sollevate (ma se proprio necessario, ahimé, sarei anche disposto a farlo). Tanto più che alcune di queste pongono anche questioni legittime: non esiste, del resto, un articolo scientifico privo di limiti, e riconoscerli e discuterli è parte integrante del lavoro di ricerca.
Tuttora ignoro quali sarebbero le “questioni legittime” che ho sollevato.
Nei commenti, invece, Farci scrive:
Nessuno sostiene che per criticare una ricerca sia necessario essere specialisti del settore. Un paio di criticità sono anche corrette. In altri casi, quelli che vengono individuati come errore metodologici non lo sono.
Il primo requisito indicato nel carosello, insomma, nei commenti si ammorbidisce parecchio: non serve essere specialisti, e alcune criticità sono corrette; le altre però «non sono errori metodologici», senza che venga spiegato perché.
Non ho mai fatto mistero di non essere una specialista di sociologia, ma i punti strutturali sollevati nella mia critica non sono questioni di terminologia: riguardano la logica stessa della ricerca empirica. Dire che «non sono errori metodologici» senza mostrare perché equivale a chiedere di fidarsi sulla parola.
Inoltre, Farci ricordava la necessità di «criticare ciò che gli autori hanno effettivamente scritto»: ed è esattamente ciò che ho fatto, citando e analizzando le loro tesi testuali (dalle affermazioni causali sulla “porta d’ingresso” alle generalizzazioni da singoli commenti). Le repliche emerse finora (che esamino più avanti) non sono entrate nel merito di questi passaggi, che restano dunque senza risposta.
Sembrerebbe insomma che il criterio per considerare accettabile la critica di un “non addetto ai lavori” si riduca a una scelta del tutto arbitraria: è valida finché segnala refusi o omissioni minori, diventa “incompetenza” o “delegittimazione” non appena mette a nudo i vizi di fondo dell’impianto di ricerca.
Sotto al carosello di Farci qualcuno lo ha fatto notare a Leonardo Laviola, che riteneva inutile il confronto con chi non ha «le competenze di base in ambito accademico e metodologico»:
le competenze specialistiche di un dominio non coincidono necessariamente con quelle logico-metodologiche, che sono in larga misura trasversali
Laviola ha risposto con un paragone: «È come se io mi mettessi a suonare Chopin davanti a te per poi sentire se TU pensi che sia una buona esecuzione, quando non hai le basi della disciplina». Un paragone che però, a ben vedere, conferma il punto: per accorgersi che un pianista ha saltato una battuta non serve essere concertisti di alto livello, basta avere lo spartito sotto gli occhi e saper leggere la musica (cosa che, per inciso, il mio diploma di conservatorio mi permette di fare con discreta sicurezza). Ed è quello che ho cercato di fare, citando sempre il testo del paper e i numeri di pagina.
Limiti o errori?
l’AI tende spesso a confondere i limiti metodologici di una ricerca con veri e propri errori metodologici […] presentare come difetti che invaliderebbero lo studio quelli che sono, in realtà, limiti legati a scelte metodologiche del tutto legittime. In altri casi viene fatto dire al mio paper cose che non dice.
Non ho mai scritto nella recensione che il paper sia stato invalidato. L’ho definito ad esempio «una nota esplorativa utile», e anche «che le prove siano deboli non rende false le conclusioni del paper». Inoltre come già detto non ritengo di avere attribuito al paper posizioni che non sostiene o che non si possano dedurre ragionevolmente da esso.
L’accusa di aver usato l’AI
[La vicenda è interessante per una ragione che] Riguarda il modo in cui l’intelligenza artificiale sta trasformando il nostro rapporto con la conoscenza e, soprattutto, con l’autorevolezza scientifica.
Il carosello passa poi a un’accusa, allusa nel carosello e resa esplicita nei commenti ma mai circostanziata, del fatto che l’analisi non sarebbe farina del mio sacco: secondo Farci, infatti, tutto quello che ho fatto sarebbe stato far leggere il paper a un’intelligenza artificiale, che avrebbe individuato al posto mio tutte le criticità di cui ho poi scritto nell’articolo, o addirittura farmi scrivere direttamente l’articolo senza il minimo sforzo, magari utilizzando un prompt appositamente fazioso che avrebbe poi generato un testo estremamente sbilanciato dal lato dei difetti.
Non è quello che è successo, ma per quanto mi riguarda ciò non ha neanche chissà quale importanza. Il punto infatti è che questa accusa viene portata avanti senza la minima prova, per cui non mi sarebbe possibile presentare contro-evidenze neanche volendo.
Questa non è neanche la parte più seria, però:
Oggi chiunque può sottoporre un articolo a un modello linguistico e chiedergli di individuarne dieci, venti o trenta criticità metodologiche. Provate a farlo con qualsiasi saggio, anche molto più autorevole dei miei, e il risultato sarà probabilmente un elenco di osservazioni formulate con un linguaggio tecnico, ordinate in modo convincente e corredate da concetti che appartengono effettivamente al lessico della ricerca scientifica. Il problema è che, se sottoponeste lo stesso identico articolo al medesimo modello, chiedendogli questa volta di individuarne i punti di forza, i contributi originali e gli elementi di solidità metodologica, potreste ottenere un’analisi altrettanto articolata e convincente, ma di segno opposto. Quale delle due valutazioni sarebbe quella corretta? Potenzialmente entrambe, almeno in parte. Oppure nessuna delle due. Ed è proprio questo il punto: Un modello linguistico può essere molto abile nel costruire argomentazioni contro una ricerca. Ma mostrerà sempre limiti significativi nella capacità di valutarla scientificamente in profondità.
Vediamo però quello che Farci ritiene sia il nodo di tutta la questione:
Non si tratta soltanto di una mia impressione. Esiste ormai una letteratura scientifica che ha iniziato a interrogarsi proprio sull’affidabilità dei modelli linguistici nella valutazione degli articoli accademici. Uno studio pubblicato nel 2025 su Clinical and Translational Discovery (Zhu et al., 2025), per esempio, ha esaminato la capacità di un modello linguistico di produrre revisioni scientifiche[…] Quando al modello veniva chiesto di formulare una normale peer review, le sue valutazioni mostravano una corrispondenza piuttosto limitata con quelle dei revisori umani, soprattutto quando queste ultime erano approfondite e dettagliate. Quando invece gli veniva chiesto esplicitamente di produrre argomentazioni per respingere un articolo, il modello riusciva a generare osservazioni che gli esperti giudicavano spesso ragionevoli e convincenti. Gli stessi autori mettono in guardia dal rischio che questa capacità venga utilizzata per manipolare il processo di peer review, producendo valutazioni orientate verso un esito prestabilito e conferendo loro un’apparenza di autorevolezza scientifica.
Lo studio citato s’intitola Evaluating the potential risks of employing large language models in peer review [Zhu et al. 2025], e la lettura che ne dà Farci è grossomodo corretta. Fondamentalmente, il rischio dell’utilizzare un’AI per elaborare una valutazione non è tanto nella review in sé ma nell’intento dell’autore del prompt: se un reviewer strutturasse il suo prompt di generazione della revisione appositamente in modo ultra-critico, col preciso intento di arrivare a un rifiuto, o viceversa per occultare magari dei difetti che avrebbero potuto risultare in una rejection, e se la revisione dell’AI risultasse convincente, sarebbe ovviamente un problema per l’equità del processo.
Quello che non viene detto da Farci, tuttavia, è che gli autori indicano già quale sia una possibile soluzione (che poi, da parte di una che con le AI ci lavora ogni giorno, è la stessa di virtualmente qualsiasi applicazione dell’AI), ovvero utilizzare l’intelligenza artificiale come un supporto, e non come un rimpiazzo, al lavoro di esseri umani già competenti. Gli autori scrivono infatti:
Sebbene i LLM siano in grado di riprodurre la forma della critica accademica, la loro comprensione della logica sostanziale e del ragionamento scientifico nelle sue sfumature può risultare limitata, compromettendo la reale profondità delle loro valutazioni. Una revisione tra pari di alta qualità richiede che i revisori possiedano una profonda conoscenza di base della disciplina, una comprensione delle tendenze di sviluppo nel campo di ricerca, nonché l’esperienza e l’intuito necessari per individuare l’innovazione. Si tratta di ambiti in cui gli attuali modelli LLM presentano delle lacune. [Traduzione mia]
Parlano inoltre dell’over-reliance, ovvero l’eccessiva confidenza, nei confronti dell’AI come problema che può compromettere il processo di peer review - non l’utilizzo dell’AI in quanto tale. Un utilizzo cieco di una review “artificiale” potrebbe risultare sia in una rejection ingiusta di un paper magari non perfetto ma comunque utile per far progredire la ricerca, sia in un paper mill, ovvero un produttore seriale di paper fraudolenti, che manipolano il processo per convincere un editore a farsi pubblicare.
D’altro canto il paper cita ad esempio studi che, seppure con le dovute limitazioni, mostrano benefici nell’utilizzo delle AI nella produzione delle review, per esempio nel ridurre l’affiliation bias (il giudizio del revisore è condizionato dalla sua affiliazione all’autore del paper).
La situazione, insomma, è complessa e va senza ombra di dubbio affrontata con cautela, dal momento che presenta numerose sfide di cui non abbiamo del tutto contezza. Tuttavia non è neanche giusto presentare l’uso degli LLM nella ricerca e nelle peer reviews come totalmente negativo: il suggerimento finale degli autori alla comunità accademica è quello di implementare azioni basate principalmente sulla trasparenza del processo (ad esempio richiedendo che gli autori e i revisori dichiarino un loro eventuale utilizzo delle AI), e la proibizione completa dell’intelligenza artificiale riguarda più una questione di sicurezza dei dati (uno studio inedito potrebbe venire divulgato prima del tempo) che non gli svantaggi analizzati.
Il paper dichiara con trasparenza i limiti dello studio: ad esempio il campione di dimensioni ridotte e limitato al campo della ricerca oncologica, dunque i risultati potrebbero non essere applicabili a paper di altri campi; inoltre, il modello utilizzato è stato una versione che ai tempi della ricerca era probabilmente non la più avanzata disponibile (Claude 2.0 è stato rilasciato a luglio 2023, e la versione 3.0 era già disponibile a marzo 2024) 1, e il confronto utilizzando altri modelli prominenti come GPT-4 o Gemini 1-1.5 non è stato effettuato.
Finora il succo del carosello ha riguardato i rischi dell’utilizzo dei modelli linguistici nella produzione di revisioni scientifiche, sebbene l’articolo in questione, lo ripeto, non fosse in alcun modo un lavoro di peer review (e soprattutto nella totale assenza di prove che un’AI sia stata effettivamente utilizzata per la produzione dello stesso). Dal paragrafo successivo si inizia a capire meglio dove voglia andare a parare:
La questione diventa ancora più interessante quando chi utilizza questi strumenti parte già da una convinzione precisa: per esempio, che un determinato articolo sia ideologicamente orientato, metodologicamente scorretto o semplicemente privo di valore.
Il paper di Zhu e colleghi ha esaminato possibili rischi di utilizzo malevolo o biased dell’AI, tra cui per l’appunto come una valutazione che conferma i pregiudizi dell’autore della review (anche se si trattasse di semplice buona fede). La slide però procede così:
Il risultato può essere paradossale e pericoloso: persone che non possiedono gli strumenti necessari per valutare una ricerca scientifica si ritrovano improvvisamente a disposizione un repertorio di obiezioni metodologiche apparentemente sofisticate. E così possono presentarsi come esperti, mettere pubblicamente in discussione la credibilità di un ricercatore e alimentare, presso un pubblico altrettanto manchevole degli strumenti per verificare quelle critiche, l’impressione che un intero lavoro scientifico sia stato definitivamente confutato. Scacco matto “espertone”!
Si passa insomma a parlare della mia recensione nello specifico: essendo a quanto pare ricca di «obiezioni metodologiche apparentemente sofisticate», potrebbe apparire all’occhio di un non esperto come un lavoro scientificamente credibile.
Inutile dire che mancano completamente almeno tre punti:
- una qualsivoglia dimostrazione che le obiezioni siano sofisticate solo “apparentemente”, e non “realmente”;
- qualche dato che mostri effettivamente che tali obiezioni sono frutto di una manipolazione dell’AI, piuttosto che semplicemente farina del mio sacco, e dunque che all’atto pratico gli strumenti necessari per valutare il paper mi manchino;
- un commento sul fatto che le obiezioni da me poste sono verificabili da chiunque, in quanto ho avuto premura di citare le espressioni precise e indicare i numeri di pagina, e che sono scritte con un linguaggio accessibile anche a lettori a cui tali strumenti eventualmente mancassero, proprio perché ognuno possa controllarle da sé.
Il “prompt” e la “skill”
Tra i commenti al carosello di Farci c’è anche questo:
non so se hai letto cosa ha commentato chi gestisce la pagina ad una provocazione del tipo “quale prompt hai usato per generare il carosello”. La risposta qualcosa del tipo “il prompt non dice nulla, perché ho inserito le skill e allenato l’IA per fare revisione scientifica”. Praticamente usa Claude, ritiene di averlo addestrato bene e, quindi, con due aggiustamenti di prompt la tesi diventa scientifica.
Questo commento merita una precisazione, anche perché Farci lo ha preso per buono e lo ha indicato come uno dei motivi per non rispondere nel merito:
eh?? ? Non ci credo! Uno dei motivi per cui mi sono rifiutato di rispondere punto per punto…non partecipo ad un gioco se l’altro giocatore sta barando
Questo è lo scambio originale, sotto al mio carosello:
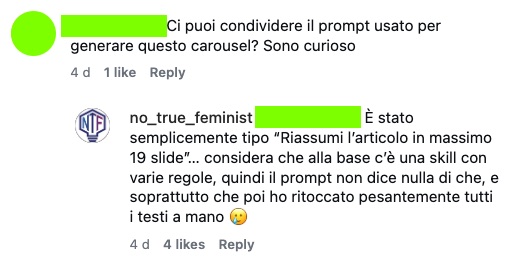
L’utente mi chiedeva il prompt usato per il carosello, non per l’articolo. Come ho scritto nella cronologia, e come dichiaro da tempo, i testi delle slide li ricavo con Claude a partire dall’articolo del blog, che scrivo io; la “skill” di cui parlo è l’insieme di regole che uso per questo passaggio, cioè per trasformare un articolo in slide, e con la revisione scientifica non ha niente a che fare 2. Nella stessa risposta specificavo anche di aver ritoccato a mano tutti i testi.
Nessuno ha quindi “allenato l’IA per fare revisione scientifica”, e la frase riportata nel commento non l’ho mai scritta. Ma è bastata una parafrasi sbagliata, riportata da un terzo, perché Farci concludesse che stavo «barando».
L’articolo di Donata Columbro
Lo stesso giorno in cui è uscito il carosello di replica firmato da Farci, mi è anche stato segnalato un breve articolo pubblicato da Donata Columbro sul suo Substack, dal titolo indicativo:
Quando il prompt è antisessista e antifemminista: cosa succede quando l’IA viene usata per fare una presunta revisione scientifica
L’articolo si apre menzionando il mio carosello pubblicato lo scorso 7 ottobre contestualmente alla mia analisi critica di un altro paper, stavolta riguardante le presunte implicazioni economiche delle «norme di mascolinità». Il mio articolo in particolare si interrogava sulla solidità della parte empirica della rassegna: l’indice usato per misurare la mascolinità si sovrapponeva in parte agli esiti che avrebbe dovuto predire, veniva confrontato tra uomini e donne e tra paesi senza le verifiche necessarie, e produceva effetti modesti; e metteva in discussione anche i criteri di prova, molto più severi con l’ipotesi biologica che con le norme di mascolinità.
Come faccio sempre, anche in questo caso sono io la penna (o per meglio dire, le dita sulla tastiera) dietro alla scrittura dell’articolo; tuttavia, e lo dichiaro senza problemi, nella fase di ricerca ho fatto effettivamente un uso più consistente del solito di alcuni tool basati sull’intelligenza artificiale (NotebookLM, Perplexity, Claude) per orientarmi e verificare lo “stato dell’arte”, trattandosi di un paper piuttosto complesso che discorreva, oltre che di economia, anche di biologia evoluzionistica, antropologia, psicologia sociale, salute e istruzione. La firma dell’articolo, insomma, è a buon diritto mia, così come la responsabilità di tutte le affermazioni (ed eventualmente delle castronerie) scritte.
L’articolo si concludeva con alcune considerazioni sull’articolo / carosello pubblicato da SkyTG24 a commento del suddetto paper, ad esempio facendo notare che si erano un po’ perse per strada le cautele degli autori. È qui che entra in scena Donata Columbro, appunto, dal momento che l’articolo di Sky era a firma sua, e inoltre l’articolo consisteva in un commento misto a intervista sempre a Manolo Farci.
Da quanto si legge in “Quando il prompt è antisessista e antifemminista”, Columbro avrebbe appreso del mio articolo tramite lo stesso Farci, seppure subito dopo la pubblicazione io abbia provato a contattarla tramite Instagram e poi email, senza però ricevere risposta.
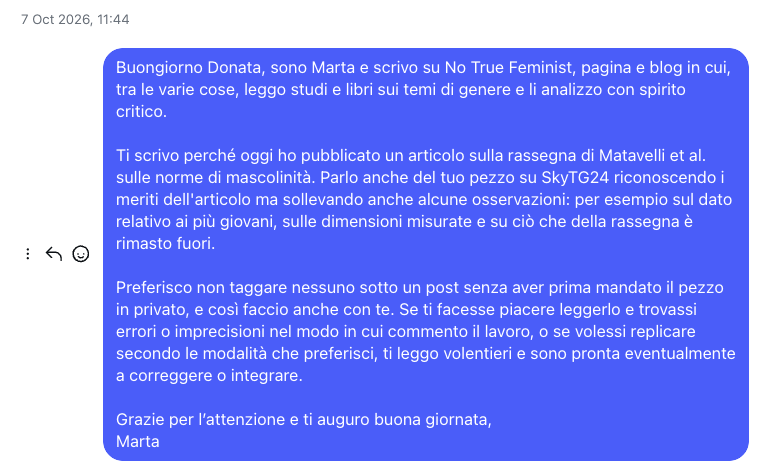
Ciò che ho trovato interessante è però nel secondo paragrafo:
Il carosello riportava una serie di critiche che mi hanno ricordato subito lo stile perentorio di Claude quando gli chiedo di farmi il fact-checking di un pezzo o di “agire come editor” per verificare la coerenza dei temi e delle citazioni che metto insieme. Un tono che non lascia spazio a sfumature e sembra - sembra - presentare la realtà così com’è […]. Ma ovviamente un punto di vista c’è. Quello che lui ha ritenuto opportuno utilizzare sulla base della nostra storia comune […] oppure quello che gli ho indicato io in partenza. Un’altra persona […] probabilmente otterrebbe un risultato diverso.
In pratica Columbro descrive non solo il funzionamento “standard” delle intelligenze artificiali generative, in cui il risultato dipende in larga parte dal prompt utilizzato e dal contesto costruito dalle conversazioni passate (anche se è sempre possibile iniziare da zero, ad esempio in Claude disattivando la “memoria” o iniziando una sessione in incognito), ma anche abbastanza bene il mio processo di scrittura degli articoli utilizzando un’AI a supporto, in cui il punto di vista è appunto «quello che gli ho indicato io in partenza».
Il pezzo continua infatti richiamando la mia recensione al paper di Farci:
A Manolo Farci è successa la stessa cosa, e di nuovo lo stile “artificiale” è abbastanza evidente. Il problema non è usare le IA per capire meglio dei paper o dei report infiniti, anzi. […] anche usare l’IA per scrivere meglio può essere lecito, non è questo il punto. Il problema è quando lo stile freddo della macchina diventa sinonimo di oggettività (anche in modo implicito, chiedendo per esempio di rispondere “nel merito” dei punti sollevati).
Da quanto scrive, Columbro è venuta a conoscenza della faccenda tramite Farci (sotto al cui carosello tra l’altro lei stessa ha commentato: «Ma no ma no, l’intelligenza artificiale è oggettiva :DDD»), e i miei messaggi sono rimasti senza risposta. Immagino dunque che abbia preso per buone le accuse di Farci che io abbia utilizzato Claude in modo “cieco”, chiedendo di evidenziare tutti i limiti dell’articolo senza metterci del mio e soprattutto sfruttando la parvenza di oggettività che lo stile di Claude possiede per conferire alla recensione un valore scientifico che in realtà, se uno gratta un minimo la superficie, non c’è.
Non serbo nessun rancore nei confronti di Columbro. I punti che solleva però sono molto interessanti alla luce delle accuse sollevate da Farci nei miei confronti: se siamo d’accordo che l’utilizzo di un’IA non sia di per sé un male, e se è assodato che tendenzialmente ogni testo generato da un Claude e simili possieda uno stile che “suona oggettivo”, allora il problema, se c’è, non sta forse in chi il prompt l’ha formulato e premuto invio? Non è forse vero che ognuno di noi possiede una propria visione del mondo, che si riflette anche nei risultati ottenuti con l’ausilio di un’intelligenza artificiale come si rifletteva nei propri testi prima che ChatGPT venisse al mondo?
Sembra si ritorni sempre al punto che la “replica” di Farci ha evitato accuratamente per 7 slide: il modo per verificare se un testo, che sia scritto da un umano o da una macchina pseudo-intelligente non importa, ha davvero della sostanza e non “suona” semplicemente oggettivo è - rullo di tamburi - verificare se tale testo ha davvero della sostanza. In poche parole, esaminarlo nel merito.
Lo rimarco di nuovo a scanso di equivoci: io ho letto per intero [Farci e Righetti 2019], io ho notato i limiti metodologici e gli altri problemi interni di logica e consistenza, e sempre io durante la lettura e la stesura della bozza ho fatto ricerche per essere ragionevolmente certa di quanto stavo scrivendo. Claude mi ha sì supportato nella revisione della bozza, per esempio aiutandomi a verificare che le citazioni del paper e degli altri riferimenti bibliografici corrispondessero a quanto sostenuto negli stessi, o più semplicemente correggendo sviste e ripetizioni - ma la responsabilità di ogni frase che ho scritto rimane mia, in quanto l’intero documento è il frutto del mio lavoro di argomentazione.
Sotto al carosello di Farci qualcuno ha scritto:
ci vuole una persona, eventualmente anche supportata dall’ia, ma sempre una persona che sia esperta dell’argomento e che possa valutare l’articolo sulla base delle proprie competenze. Nessuno qui è contro l’ia, io la uso per lavorare figuriamoci, ma credo che sappiamo tutti che non si può chiedere all’ia qualcosa e non metterci mano, non verificare, non controllare, non correggere. Prendere per buono quello che ti dice un’ia è stupido, soprattutto su argomenti soggetti a bias come le scienze sociali, soprattutto perché l’ia contiene dati parziali già di partenza, soprattutto se le domande le sono rivolte in modo tendenzioso (perché tende a darti ragione anche quando spari puttanate, e questo spero sia ovvio a chiunque la usi)
Sono d’accordo, ed è esattamente quello che ho fatto.
Colpisce, in buona sostanza, che a quanto sembra sia sufficiente il commento critico di una persona qualunque - va detto, con un background di studi scientifici ed esperienza nella ricerca accademica, peer review compresa, ma pur sempre una non esperta di sociologia - su una pagina Instagram da poche migliaia di iscritti a mettere in crisi non solo un paper scientifico ma addirittura la credibilità di due ricercatori.
Eppure basterebbe così poco per sgonfiare il mio ego, apparentemente così smisurato da portarmi a osare di scrivere una critica a un paper pubblicato, e riportarmi dove merito di stare: replicare nel merito alle obiezioni che ho sollevato, demolendole pezzo per pezzo come un autore esperto e sicuro del proprio lavoro dovrebbe essere in grado di fare senza problemi. Sarà stato fatto?
Le repliche nel merito (?)
Dopo che alcuni utenti (nomi a me noti solo in parte - ci tengo a sottolinearlo come evidenza che non siano stati mandati da me) avevano commentato sotto al post con richieste quali:
Risponda sul merito punto per punto
Mai una risposta sul merito, mi raccomando. Vi hanno asfaltato di nuovo.
Sarebbe interessante la risposta puntuale sul merito, ma tralasciamo.
Farci si è deciso, almeno in apparenza, ad affrontare nel merito almeno un paio di punti. Li analizzo di seguito.
La saturazione nella grounded theory
Già nel carosello, Farci scriveva:
[…] le critiche rivolte al mio articolo ne offrono diversi esempi: concetti metodologici utilizzati impropriamente, limiti attribuiti alla ricerca che non corrispondono ai suoi obiettivi e contestazioni rivolte a conclusioni che gli autori non hanno mai formulato. Basterebbe leggere questa frase tratta dal carosello: «…nella grounded theory la saturazione è il criterio con cui si chiude lo sviluppo delle categorie, non un criterio di campionamento» per intuire che chi l’ha “scritta” ha poca dimestichezza con certi concetti
I tre “esempi” appena citati sono però estremamente vaghi e poco utili per capire gli eventuali errori della mia critica. Il terzo in particolare riprende il secondo «requisito» menzionato all’inizio; ed è un genuino peccato dal momento che, se i primi due possono effettivamente riguardare sfumature di significato che richiedono una conoscenza specialistica, che naturalmente non ho, quest’ultimo sarebbe invece un errore piuttosto grave di deduzione che è risultato in un’attribuzione indebita, il che sta abbastanza in alto nella scala delle fallacie logiche che quando scrivo faccio del mio meglio per evitare.
L’unico esempio concreto che viene citato compare effettivamente nel mio carosello (slide n.9) e, con una formulazione equivalente, anche nell’articolo integrale. Essendomi però accorta in fase successiva che quella formulazione era imprecisa, avevo provveduto da sola a correggerla nell’articolo, segnalando poi la questione in una story per il beneficio di chi aveva letto il carosello solo su Instagram.
In sostanza avevo descritto la cosa in modo troppo netto, e me ne prendo la responsabilità: nella grounded theory il campionamento teorico prosegue proprio fino alla saturazione (cioè quando la raccolta e l’analisi di dati aggiuntivi non rivelano più nulla di nuovo rispetto all’argomento), quindi a conti fatti è legittimo usarla come regola di arresto. Il problema reale, e che rimane invariato, è un altro: quella regola funziona solo se il campionamento teorico è documentato, cioè quali categorie hanno guidato la scelta dei materiali e come si è stabilito che non emergeva più nulla di nuovo; nel paper non c’è niente di tutto questo.
La mancanza di conoscenza profonda di un argomento non è sufficiente a dimostrare che le obiezioni non siano mie e che sia stata un’intelligenza artificiale a scrivere l’articolo al posto mio.
Nei commenti, Farci torna sull’argomento:
viene detto che la saturazione teorica rende lo studio non replicabile. Ma no!! La Grounded Theory non è un protocollo sperimentale da riprodurre meccanicamente. Non è un esperimento in vitro. È una metodologia qualitativa che si basa su un processo di raccolta e analisi dei dati, nel quale le categorie interpretative per capire un fenomeno vengono progressivamente costruite attraverso il confronto costante con il materiale empirico (che può essere osservazione partecipante o etnografia digitale, interviste, analisi testuale etc.)
Qui Farci ha ragione sul termine: «replicabile», riferito a uno studio qualitativo, era la parola sbagliata, perché nessuno si aspetta che un altro gruppo di ricerca, rileggendo gli stessi post, arrivi alle stesse identiche categorie. Quello che si chiede alla ricerca qualitativa è però che il percorso sia tracciabile: quali materiali sono stati letti, con quali criteri sono stati scelti, come si è passati dai singoli commenti alle categorie e come si è stabilito che non emergeva più nulla di nuovo.
È quello che in letteratura si chiama audit trail, e nel paper non c’è. Anche correggendo il termine, insomma, il punto della mia critica rimane lo stesso: senza queste informazioni chi legge non ha modo di verificare come gli autori siano arrivati alle loro conclusioni.
In un altro commento aggiunge:
ha scritto che gli standard minimi di qualsiasi ricerca empirica valida sono la rappresentativita’ del campione (in pratica la ricerca qualitativa non esiste)
Qui si riferisce alla “nota metodologica” che ho messo a inizio recensione, nella quale però mi riferivo in modo generico alla ricerca scientifica. Nel merito del paper, infatti, la critica riguardava la generalizzazione a partire dal campione, non la rappresentatività in sé.
Devo ammettere, però, che la formulazione della nota si prestava all’equivoco: ho scritto «gli standard minimi di qualunque ricerca empirica, come la rappresentatività del campione e la replicabilità», e nella ricerca qualitativa la rappresentatività statistica non è un obiettivo. Come per la saturazione, ho provveduto a correggerla nell’articolo.
“Una rete costruita attorno a una sola pagina”
È vero. E allora? Utilizzare una seed page, cioè una pagina di partenza, è una procedura consolidata nella Social Network Analysis, non un errore metodologico. Naturalmente, comporta dei limiti. L’importante è esplicitare la procedura adottata e non attribuire ai risultati una portata che non possono avere. Ed è esattamente ciò che abbiamo fatto! Certo che, se avessimo scelto un’altra pagina di partenza, avremmo potuto individuare nodi differenti. E quindi? Qualsiasi ricerca empirica richiede di delimitare un campo di osservazione. Questo vale soprattutto per le metodologie qualitative, nelle quali l’obiettivo non è necessariamente ricostruire un intero universo (cosa impossibile), ma comprendere in profondità determinati fenomeni, pratiche e relazioni. Facciamo un esempio. Se volessi studiare qualitativamente il fenomeno delle persone senza dimora, potrei scegliere una specifica comunità, un dormitorio o un quartiere, etc. e partire da lì per sviluppare la mia analisi. Naturalmente, scegliendo un’altra comunità, incontrerei persone diverse e raccoglierei testimonianze differenti. Questo renderebbe la mia ricerca metodologicamente sbagliata? Evidentemente no. Esistono persino intere tradizioni di ricerca qualitativa fondate sullo studio approfondito di singoli casi, comprese le storie di vita di una sola persona. Nessuno pretenderebbe che quella persona rappresentasse statisticamente tutte le altre. Il fatto che si definisca questo un limite deriva da una incomprensione di come funziona la ricerca sociale.
La replica si è concentrata su una singola frase senza apparentemente considerare l’intero contesto della critica. Quest’ultima, riassumendo, riguardava il fatto che la rete che il paper chiama «rete MRA italiana» è solo l’insieme dei like messi a partire da un’unica pagina, che non misurano né l’affinità ideologica né il pubblico condiviso; è stata ridotta a 46 pagine senza criteri dichiarati né verificabili, includendo anche pagine dalla dubbia pertinenza come quelle legate alla prevenzione di problemi di salute maschile, e poi solo visualizzata, mai analizzata, per cui non può rappresentare i gruppi maschili italiani né provare che i «due filoni» esistano davvero.
Ritengo sia chiaro a chiunque legga il paper che la procedura adottata rimanga decisamente opaca: per esempio, da oltre 3000 nodi si è scesi a 46 pagine tramite etichettatura manuale di realtà «pertinenti» alla sfera MRA priva di criteri esplicitati; la classificazione delle 7 categorie ricalca le auto-descrizioni delle pagine senza che la procedura sia documentata; e in generale non è stato dichiarato quanti post e commenti siano stati letti, su quali pagine e in quale arco temporale, risultando in una mancanza di contestualizzazione strutturale delle citazioni prese in esame.
Riguardo poi alla portata che si attribuisce ai risultati, il paper non si limita a descrivere la cerchia di una pagina: dichiara di aver ricostruito «the Italian Facebook men’s rights movement» (p. 768) e di aver trovato «due trend dominanti nella rete MRA italiana» (p. 770). Tutto ciò viene fatto, ripetiamolo, a partire da una singola pagina: ne consegue che qualsiasi community non collegata al nodo iniziale risulti invisibile per costruzione.
L’errore non risiede dunque nell’uso in sé della tecnica di estrazione della rete tramite “mi piace” (procedura legittima per analizzare la cerchia relazionale di una specifica pagina), ma nel presentare i risultati come la mappa del movimento maschile italiano.
Ulteriore procedura opaca riguarda ad esempio il fatto che due delle subculture citate, incel e MGTOW, non siano presenti nel campione, eppure gli autori traggono conclusioni generalizzate su di esse a partire dal campione, nonostante ad esempio la letteratura le collochi prevalentemente su piattaforme ben diverse da Facebook (forum, Reddit, 4chan, Telegram…).
Infine, l’aspetto forse più evidente riguarda il ripetuto passaggio dai commenti di singoli utenti (in molti casi senza che venga specificato da quale pagina sono stati presi, se fossero amministratori oppure utenti generici, quale fosse eventualmente il contesto del commento…) agli atteggiamenti e alle posizioni ideologiche dell’intera community, per non dire dell’intera rete.
Per riprendere il suo parallelismo, sarebbe stato come se gli autori avessero fatto un’etnografia studiando uno specifico dormitorio, e magari intorno ad esso soltanto una rete presente nel medesimo quartiere o la stessa città, e avessero intitolato il paper “I senzatetto in Italia” ritenendo di avere il quadro completo dell’intero fenomeno su scala nazionale. L’errore non sta nello studiare un campione ristretto: sta nel pretendere che da tale campione ristretto e sbilanciato si possa definire l’architettura, le motivazioni e il funzionamento di un intero movimento sociale.
“Un quadro interpretativo che non può essere smentito”
Anzitutto, l’autrice del post sembra ignorare che è normale per un articolo scientifico presentare una rassegna della letteratura, ossia una ricostruzione dello stato dell’arte rispetto al fenomeno studiato. Questa funzione come una cornice interpretativa che orienta le domande, la raccolta dei dati e la costruzione delle categorie analitiche. Ma non significa che i risultati siano già stabiliti in partenza. Infatti, quello che noi troviamo è un panorama molto più articolato di quanto potrebbe suggerire una rappresentazione dell’attivismo maschile come fenomeno ideologicamente omogeneo (come emerge dalla review della letteratura) È vero che anche Messner parla della possibilità che l’attivismo per i diritti maschili assuma forme più moderate, meno apertamente ostili alle donne e al femminismo. Ma noi diciamo addirittura che ci sono pagine che utilizzano un linguaggio egualitario, rifiutano il determinismo biologico e sostengono i diritti LGBT. A riprova, ancora, che la nostra lettura non è ideologicamente orientata. Tuttavia, allo stesso tempo, mostriamo empiricamente un altro aspetto: l’antifemminismo non coincide necessariamente con il conservatorismo tradizionale, né richiede un’ostilità esplicita verso tutte le donne. Nelle pagine analizzate troviamo infatti forme di attivismo che rifiutano il determinismo biologico, adottano una concezione socialmente costruita del genere e talvolta sostengono i diritti LGBT, pur sviluppando discorsi di delegittimazione del femminismo. Non si tratta di un’ipotesi inventata da noi, ma di una possibilità già discussa nella letteratura scientifica (ne parla ad esempio Clatterbaugh citando la storia di Farrell), della quale individuiamo manifestazioni specifiche nel contesto italiano.
Il concentrarsi su una frase singola eludendo in pratica il succo della critica ritorna anche in questa replica.
Il problema da me evidenziato era di rigore scientifico e logica della ricerca, ovvero l’assenza di un criterio di falsificabilità. Il quadro interpretativo del paper, infatti, non è semplicemente dichiarato sulla base della letteratura precedente - procedura legittima -, bensì è costruito come un circuito chiuso:
- se una pagina è tradizionale e adotta toni aggressivi viene classificata come antifemminismo ortodosso/reazionario;
- se usa un lessico egualitario, rifiuta il determinismo biologico e sostiene i diritti LGBT, è classificata come antifemminismo «più sofisticato»;
- se cita statistiche ufficiali sui suicidi maschili, viene interpretata come un tentativo di «sminuire le disuguaglianze femminili».
La domanda epistemologica che ho posto è semplice: «Cosa dovrebbe osservare un ricercatore per concludere che un gruppo maschile NON è antifemminista?» Se non esiste alcun dato empirico capace di smentire l’ipotesi di partenza, siamo di fronte a una tautologia.
Quando Farci scrive:
noi diciamo addirittura che ci sono pagine che utilizzano un linguaggio egualitario […] A riprova che la nostra lettura non è ideologicamente orientata.
sta facendo un autogol inconsapevole, in quanto sta confermando la mia obiezione: di fronte a un dato potenzialmente contrario (il rifiuto del determinismo e il sostegno agli LGBT sono aspetti condivisi col femminismo), il loro sistema di codifica non mette per nulla in discussione la categoria “antifemminismo”, ma rietichetta per farvi entrare anche quel dato “scomodo”.
Si potrebbe obiettare che il criterio c’è, ed è la «delegittimazione del femminismo»: un gruppo che delegittima il femminismo è antifemminista per definizione. Il problema però è quanto largamente venga applicata questa etichetta, se anche citare le statistiche ufficiali sui suicidi maschili diventa un modo di «sminuire le disuguaglianze femminili». E soprattutto, anche ammettendo che quei gruppi siano antifemministi in questo senso, resta da mostrare il passaggio successivo, cioè quello dalla critica al femminismo alla misoginia, che nei dati non c’è.
Sui passaggi saltati
Un utente chiede:
perché non vengono esplicitati tutti i passaggi […]? In questo modo alcune scelte sembrano arbitrarie. Inoltre mi chiedo perché è importante la questione dell’antifemminismo/non femminismo? Si tratta di un carattere che rende più “unica” la situazione degli mra o ci sono anche altri tipi di ragionamenti? […]
Farci risponde sul primo punto:
[…] le due obiezioni che hai sollevato solo le due più importanti. Sulla prima: pur non essendoci l’obbligo di esplicitare tutti i passaggi della codifica, effettivamente si poteva dettagliare meglio la descrizione della codifica dei contenuti. Non è stato fatto per motivi di spazio (è un articolo piccolissimo e non potevamo eccedere perché la rivista non accettava contributi più lunghi. Per questo è definito “esplorativo”). Ma questo non rende i risultati arbitrari o inaffidabili. Inoltre questo lavoro non è una grounded in senso pieno (è un lavoro che mescola SNA e analisi induttiva). Vabbè, comunque sì: questa è una critica sensata
Avendo io stessa partecipato a lavori di ricerca durante l’università, ho trovato la giustificazione dei «motivi di spazio» piuttosto debole.
Quando ho scritto la mia tesi di laurea in informatica, per esempio, ho caricato il codice e i dati grezzi utilizzati in un “replication package” pubblico su GitHub, in modo che fossero accessibili a chiunque volesse consultarli. Naturalmente GitHub è solo un’opzione tra le tante (due molto famose mi risulta siano Zenodo e Open Science Framework): il punto è che i limiti di spazio di una pubblicazione accademica, cartacea o digitale che sia, non dovrebbero mai essere un ostacolo alla trasparenza. A meno che mi sfugga qualcosa, si sarebbe potuto usare tranquillamente uno di questi servizi per includere il codebook completo del lavoro, l’elenco di nodi e pagine con le relative motivazioni di inclusione/esclusione e gli esempi di codifica.
Continuando col secondo punto:
Quella è una scelta teorica degli autori. Questo non è un lavoro sugli MRA e tutte le loro ragioni (giuste o sbagliate). Anche perché sarebbero voluti dei libri interi. La scelta di esplicitare l’antifemminismo era legata all’idea che l’antifemminismo può tranquillamente andare a braccetto con posizioni “progressiste” in altri ambiti. Come avviene negli antisessisti. Poi quello che scrivo alla fine è solo un auspicio. Forse si potrebbe iniziare anche noi a accogliere certe questioni maschili, per evitare che vengano portate avanti con una logica antifemminista e puramente rivendicativa nei confronti delle problematiche femminili.
La spiegazione di Farci («l’antifemminismo può tranquillamente andare a braccetto con posizioni ‘progressiste’») riconferma esattamente il problema della mancata falsificabilità del loro modello interpretativo di cui ho scritto poc’anzi: l’antifemminismo cessa di essere un’ipotesi da verificare empiricamente attraverso indicatori trasparenti e diventa un assioma teorico stabilito a priori.
L’autore definisce poi il suo auspicio finale (aprire a un dialogo sulle istanze maschili per evitare che vengano monopolizzate dall’antifemminismo) come una semplice proposta politica. Tuttavia, i candidati naturali per questo dialogo sarebbero proprio i gruppi antisessisti ed egualitari, che però nel capitolo dei risultati del paper sono stati appena etichettati come una forma «più sofisticata» di antifemminismo. Il paper non offre alcun criterio per distinguere un moderato “genuino” da uno “strategico”.
In pratica, nel dibattito online in cui sono stata personalmente coinvolta (ma non solo), chi cita questo paper per attaccare il movimento antisessista ne utilizza i risultati per squalificare l’interlocutore, ignorandone del tutto l’auspicio finale di dialogo. Come sottolineato nella conclusione della mia recensione, finisce così per funzionare come un alibi accademico per rifiutare il confronto nel merito.
Punti fondamentali della mia critica a cui non è mai stato risposto
Le repliche di Farci hanno toccato alcuni punti, quasi sempre partendo da una singola frase che però non coglieva il succo della mia critica. Altri, che per me erano centrali, non sono mai stati affrontati, né nel carosello né nei commenti. Li elenco qui, con il rimando alla sezione della recensione in cui ne parlo. Farci si è detto disposto a rispondere a chi gli pone domande; non potendo commentare, considero questo elenco le mie.
-
I like tra pagine come indicatore. Un «mi piace» è una scelta di chi amministra la pagina e non misura né l’affinità ideologica né un pubblico in comune. Eppure il paper ci costruisce sopra la tesi che i gruppi si legittimino a vicenda attraverso gli algoritmi della piattaforma, che però non vengono mai osservati (Campionamento e costruzione della rete).
-
La rete non viene mai analizzata. I «due filoni» non sono verificati sulla struttura della rete e restano un’impressione di lettura (Campionamento e costruzione della rete).
-
Commenti degli utenti trattati come posizioni delle pagine. Il paper non distingue tra amministratori e utenti, e considera un commento non rimosso come avallato dalla community. Manca un termine di confronto (per esempio pagine femministe analizzate con lo stesso metodo) e mancano i casi negativi, cioè i contenuti che contraddicono le categorie (Il corpus qualitativo).
-
Critica al femminismo e misoginia non vengono distinte. Gli autori scrivono che il filone antisessista è orientato «più contro le femministe che contro le donne» (p. 770), ma poche pagine dopo quella stessa critica legittimerebbe «di conseguenza» gli argomenti misogini (p. 774), senza che nessun dato mostri il passaggio. Per me è il punto più importante, perché è proprio l’equivalenza su cui si regge l’uso del paper contro l’antisessismo (Un quadro interpretativo che non può essere smentito).
-
Due pesi e due misure. Le statistiche citate dalle pagine vengono liquidate come strategia retorica senza valutare se siano fondate, la vittimizzazione maschile descritta dalle pagine viene letta come «individualizzata» anche quando riguarda regolarità di gruppo, e nel caso dei gruppi antisessisti il femminismo è trattato come un blocco unico. Il test della sostituzione, cioè mettere «femminismo» al posto di «antifemminismo» nelle parti teoriche, lascia il testo identico (Due pesi e due misure).
-
Affermazioni che vanno oltre i dati. La mancata moderazione come strategia, il profilo del pubblico, la «porta d’ingresso» verso incel e MGTOW (che nel campione non compaiono), l’allineamento con la destra, il passaggio dalla Red Pill alla Casa Bianca: nessuna ha una base nei dati raccolti (Affermazioni che eccedono i dati).
-
Il salto dal 2019 al 2026. È il motivo per cui ho scritto la recensione. Il paper descrive una rete di pagine Facebook fino al 2019 e non può dire che cosa sia l’antisessismo oggi, eppure è stato citato proprio a questo scopo, anche nel carosello di uomini.in.ascolto di cui Farci è co-autore. Una risposta diretta su questo punto non è arrivata, ma i commenti dicono parecchio. Farci stesso, spiegando la scelta di parlare di antifemminismo, scrive che «l’antifemminismo può tranquillamente andare a braccetto con posizioni “progressiste” in altri ambiti. Come avviene negli antisessisti»: al presente, senza spiegare come una rete del 2019 permetta di dirlo del movimento di oggi.
Qualcuno dalla sua parte ha trovato «assurdo che tra tutti gli articoli che si potevano scegliere ha tirato fuori proprio quello che praticamente smontava l’antisessimo odierno prima di nascere», che è esattamente l’uso del paper che contestavo. E qualcun altro, sempre dalla stessa parte, ammette che «un articolo del 2019 va contestualizzato, sia negli strumenti usati che nei contenuti»; che è, in fondo, tutto quello che chiedevo (Che cosa resta vero).
Sulla presunta richiesta di retraction
Citando Wikipedia, la retraction ovvero il ritiro di un paper pubblicato avviene in quei casi in cui tale paper viene in qualche maniera smentito, in modo che i suoi risultati e le sue conclusioni non possano più essere considerati attendibili.
Pubblico per trasparenza un estratto del thread da cui è nato tutto, sempre sotto al post su Instagram:
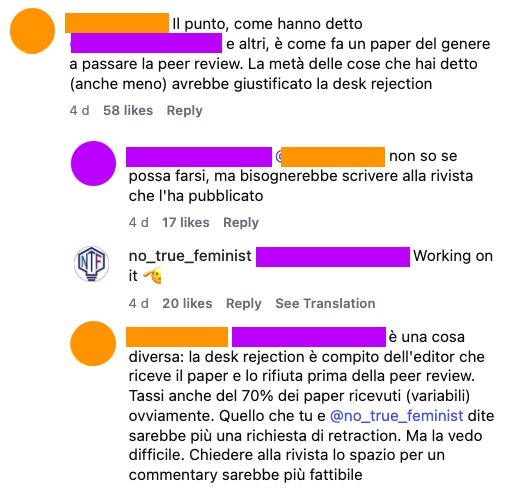
Senza fare nomi, l’utente in testa al thread è un ricercatore che lavora nel mondo accademico, ed è stato lui il primo a usare la parola retraction. Nello stesso thread, peraltro, è proprio lui a dire che una retraction la vede difficile, e che chiedere alla rivista lo spazio per un commentary sarebbe più fattibile.
Il mio «Working on it» rispondeva a «bisognerebbe scrivere alla rivista», non a una richiesta di retraction: la parola compare solo dopo, nel commento del ricercatore. Riconosco che detto così suonava come un impegno, e che era una risposta data con leggerezza: a quel punto non avevo minimamente riflettuto neanche sul se valesse la pena contattare la rivista, meno che mai a come strutturare un messaggio di contatto nello specifico, e dunque nemmeno a un obiettivo concreto.
Un paio di giorni dopo, in risposta a un altro utente che mi chiedeva conto di quella discussione, ho infatti risposto:
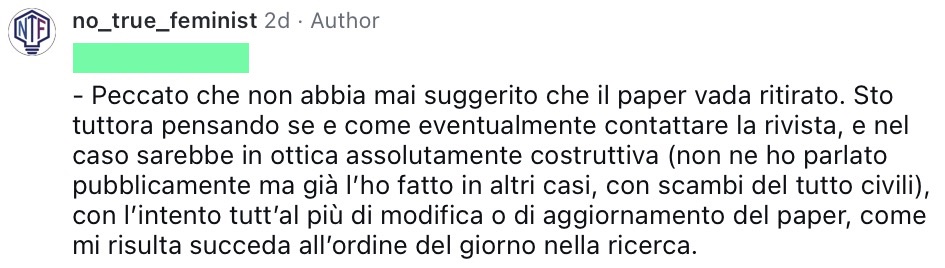
I casi a cui mi riferisco sono in buona parte relativi a recensioni o letture critiche pubblicate qui sul blog, in cui in un paio di circostanze ho scritto un’email per esempio all’editore per segnalare le mie perplessità.
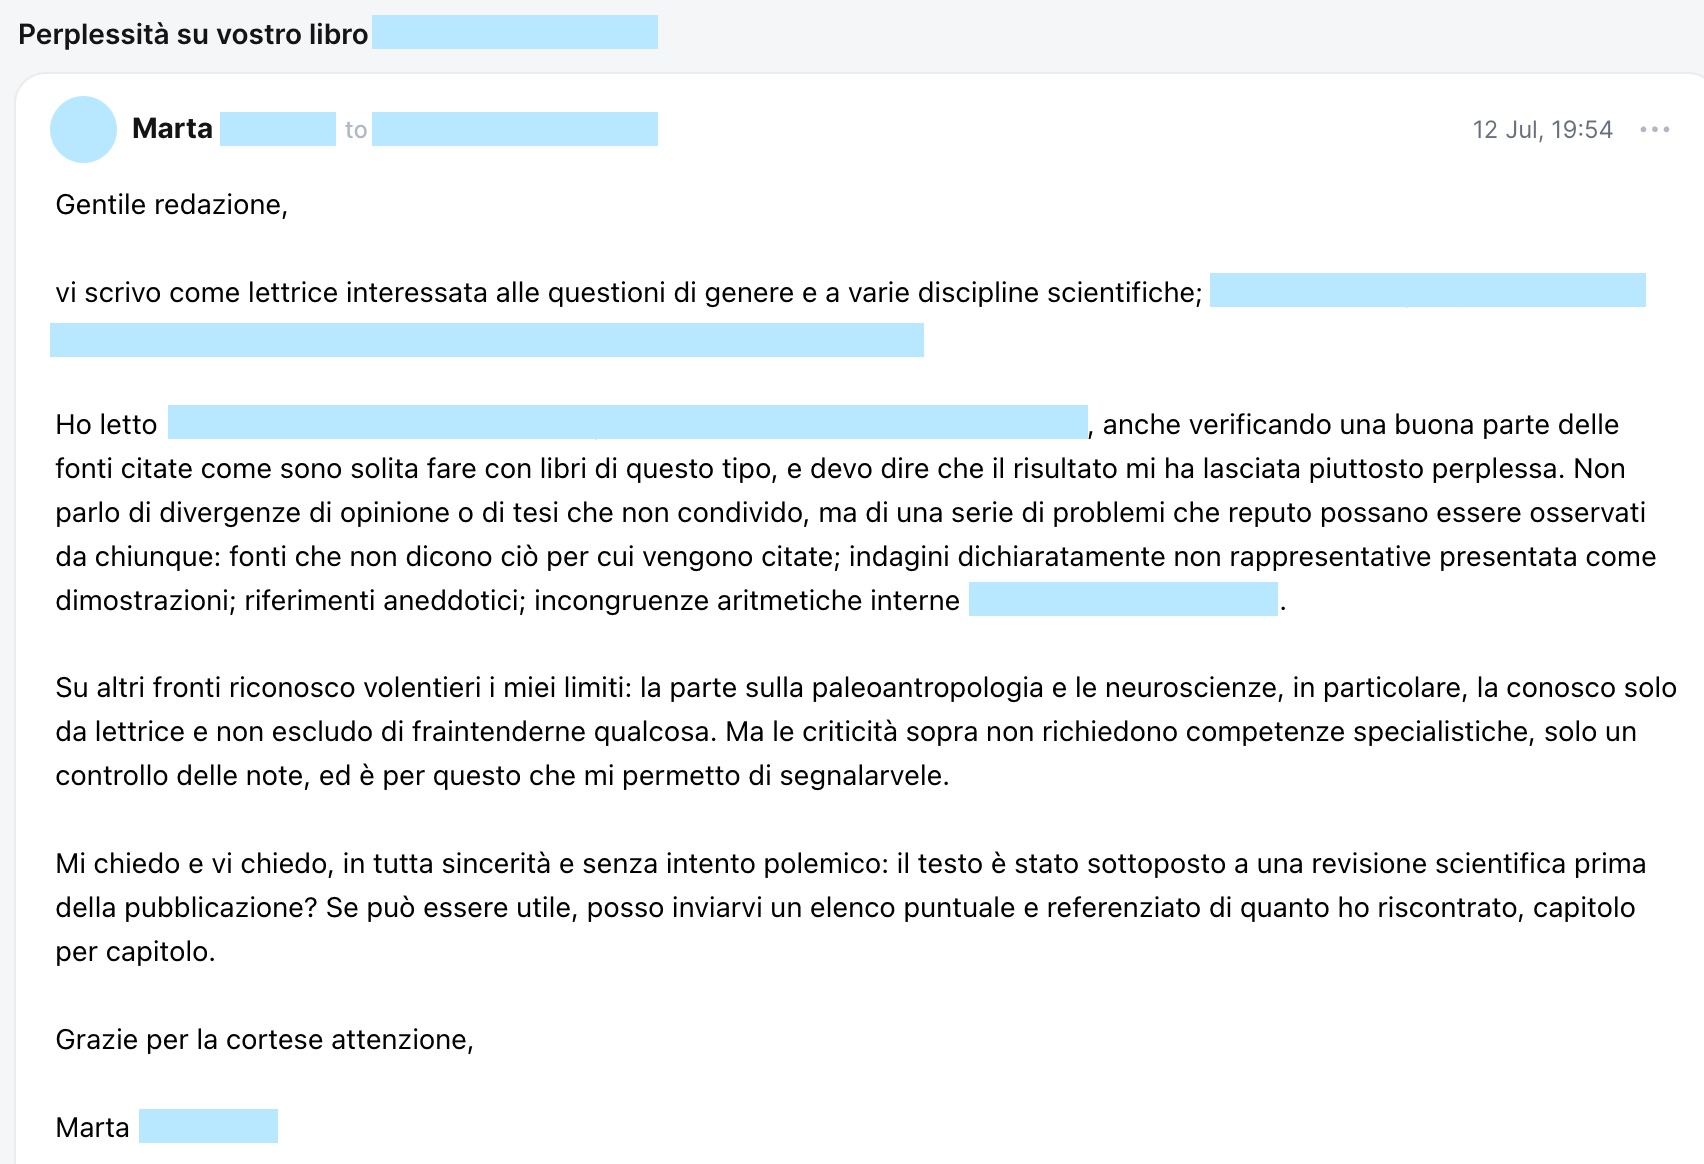
In buona sostanza, tra i commenti al carosello di Farci sono volate accuse pesanti nei confronti miei e degli utenti che avevano partecipato alla discussione - accuse di voler chiedere la censura del paper (nonostante un’eventuale retraction mantenga di norma un paper disponibile per la lettura, come successo per il celebre caso Wakefield, un caso naturalmente di tutt’altra natura) e persino di stare attuando un non meglio specificato «terrorismo epistemico».
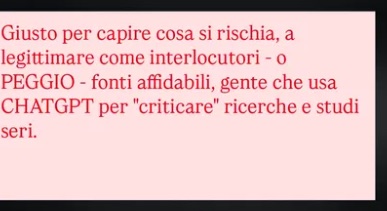
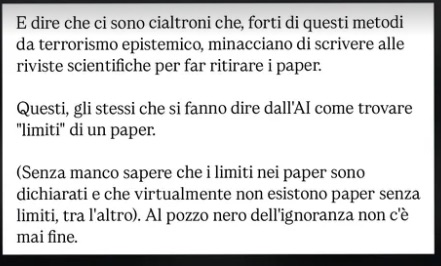
Accuse poi culminate in un callout pubblico al ricercatore in testa al thread 3 (che comunque non aveva mai “richiesto la retraction” e che anzi, come visibile dallo screenshot precedente, l’aveva giudicata difficile, suggerendo piuttosto un commentary):
C’è poi un paradosso che vale la pena notare. Sotto al carosello di Farci qualcuno ha scritto che «ci sono procedimenti appositi per criticare i paper e correggere eventuali errori, post e commenti su Instagram non hanno alcun valore». Sono d’accordo sul fatto che esistano canali appositi; ma se la critica su Instagram non conta perché non passa da quei canali, e l’idea stessa di scrivere alla rivista diventa «terrorismo epistemico», non resta molto spazio per criticare un paper, se non quello di non criticarlo affatto.
Da parte mia, ribadisco dunque che non c’è tuttora nessuna intenzione di procedere con una richiesta che il paper venga ritirato. Un’eventuale email alla rivista sarebbe tutt’al più di esposizione delle perplessità scritte nell’articolo, sulla base del fatto che la sottoscritta - e non un’intelligenza artificiale - le ritiene credibili e degne di essere sollevate, prendendomi com’è giusto che sia tutte le responsabilità nel caso decidessi di andare avanti.
Delegittimazione e toni
Il rischio “politico”
La conclusione del carosello di Farci è che:
[…] ci troviamo di fronte ad un problema enorme. Oggi dinamiche simili possono facilmente intrecciarsi con forme di attivismo che hanno come unico obiettivo screditare chi produce conoscenze considerate scomode o incompatibili con la propria visione del mondo. Il rischio, a quel punto, non è soltanto epistemologico. È anche politico.
Che abbia una mia visione del mondo è ovvio, come lo è per chiunque. Il motivo della mia critica, però, dopo oltre un anno di contenuti pubblicati, dovrebbe essere altrettanto ovvio: non il considerare “scomodi” i risultati del paper in questione, ma spiegare nel dettaglio, con ragionamenti che tutti possono seguire (in quanto si poggiano sulla logica che dovrebbe stare alla base di qualunque studio scientifico, dall’oncologia ai gender studies), perché non sono d’accordo con essi.
Il rischio epistemologico e politico esiste in primis all’interno del paper, per esempio di delegittimazione preventiva e ingiustificata di quei movimenti maschili che dovrebbero essere parte del dibattito nelle questioni di genere. Se viene ritenuto un rischio inaccettabile solo in virtù del fatto che riguarda una parte politica diversa dalla propria, viene legittimamente da chiedersi quale delle due parti in gioco sia ancorata in modo eccessivo alla propria visione del mondo, al punto che sia sufficiente una critica per costituire una minaccia quasi esistenziale.
Nei commenti, Farci scrive poi:
Se si vuole discutere in modo pacato e civile di critiche al paper, domandate e risponderò. Alcune critiche sono anche sensate, molte altre no. La delegittimazione sottostante è invece molto grave.
Al di là della validità o meno delle mie critiche (che naturalmente io sostengo ma non pretendo che nessuno le prenda per vere perché sì, anzi), si noti quanto la risposta difensiva sposti l’attenzione dal merito della critica alla presunta intenzione lesiva di chi l’ha sollevata. Fino a prova contraria la mia critica era scritta in modo pacato e civile, e Farci stesso riconosce che alcuni dei punti erano «anche sensati». Eppure il tutto viene definito come “delegittimazione”.
Sotto al carosello di Farci si legge anche:
«Un episodio gravissimo che rischia di normalizzare gli attacchi contro accademici e accademiche che si occupano di studi di genere […] un occhio esperto sa riconoscere subito una revisione fatta con ChatGPT»
Una critica pubblica a un paper pubblicato non diventa un attacco solo perché gli autori la percepiscono come tale. Da parte mia non c’è nessuna volontà di mettere in cattiva luce un paio di autori. Inoltre l’uso dell’AI si riconoscerebbe “a colpo d’occhio”, ma non viene indicato un solo passaggio significativo.
I toni
Tornando alla presunta retraction, Farci, a chi si chiedeva il motivo di una reazione così accesa, ha risposto: «vogliono chiedere la retraction dell’articolo alla rivista». Quando gli è stato fatto notare che c’era soltanto «un laconico “working on it”, un po’ poco per definirla una minaccia», la replica è stata: «hai visto male. […] Quando scriverà alla rivista le rideranno dietro. […] siete il livello massimo di disonestà intellettuale».
Qualche altro esempio, sempre dai commenti di Farci:
- a chi gli chiedeva di rispondere nel merito: «chi sei mio padre? Cambia tono», e poco dopo: «niente. semplicemente banno»;
- a proposito di un utente: «il tizio ha fatto bene a scappare. Tra l’altro è anche probabile che adesso si becca una bella denuncia per diffamazione. Così poi vediamo se ride ancora…»;
- a un altro utente: «l’unico motivo per cui non banno palloni gonfiati e maleducati come te è che mi offrite interessante materiale di studio. In particolare l’uso delle proprie competenze scientifiche come prova di virilità. Vengo qui, spacco tutto, ti faccio vedere che io faccio la scienza. Più che un confronto scientifico, una performance di mascolinità a chi ce l’ha più lungo. Facciamo a gara?»;
- e infine, riferendosi a me: «la tua guru ha solo dimostrato che usa l’ai senza neanche capire cosa ha scritto».
Riguardo al comportamento, professionale e umano, che l’autore ha tenuto con me (o con gli altri utenti che hanno commentato), lascio a chi legge qualunque giudizio.
In conclusione
Ricapitolando: il carosello di Farci mi accusava di non possedere gli strumenti per valutare il paper e di aver delegato la critica a un’intelligenza artificiale, senza però portare una sola prova né dell’una né dell’altra cosa. Quando poi, su insistenza di alcuni utenti, Farci è entrato nel merito, ne è uscito qualcosa di utile per entrambi: io ho riconosciuto e corretto le mie imprecisioni sulla saturazione, sulla replicabilità e sulla rappresentatività; lui ha riconosciuto che la codifica dei contenuti si poteva documentare meglio, e che «un paio di criticità sono anche corrette».
Restano però senza risposta i punti che per me erano centrali, a partire dai due che mi avevano spinto a scrivere la recensione: il passaggio, mai mostrato nei dati, dalla critica al femminismo alla misoginia, e l’uso di una rete di pagine Facebook del 2019 per descrivere che cosa sia l’antisessismo oggi.
Non pretendo che nessuno prenda per buone le mie critiche sulla fiducia, anzi: il paper è in bibliografia, la mia recensione ne cita sempre il testo e i numeri di pagina, e chiunque può confrontare le due cose e farsi un’idea propria. È quello che chiedo, in fondo, anche a chi ha già deciso che dietro alla recensione ci sia soltanto un prompt fazioso.
Il paper si chiude con l’auspicio di riconoscere la vittimizzazione maschile e di aprire un dialogo con i membri più moderati dei gruppi maschili. Per quanto mi riguarda, l’invito è accettato: la pagina Contatti è sempre aperta, e se qualcuno mi mostrerà dove ho sbagliato correggerò, come ho fatto finora. Basta solo, appunto, parlare di quello che c’è scritto.
Bibliografia
[Farci e Righetti 2019] Farci M., Righetti N., Italian men’s rights activism and online backlash against feminism, Rassegna Italiana di Sociologia, 60(4), 2019, pp. 765–781, doi: 10.1423/96115: https://short.do/apgSby a b
[Zhu et al. 2025] Lingxuan Zhu et al., Evaluating the potential risks of employing large language models in peer review, Clinical and Translational Discovery, 2025: https://onlinelibrary.wiley.com/doi/10.1002/ctd2.70067 ^
Note
Footnotes
-
Viene specificato che Claude 2.0 è stato scelto al momento dello studio per la capacità nativa di elaborare allegati PDF gratuitamente e senza plugin di terze parti. ↩
-
Visto che oggi mi sento generosa, ma anche a riprova che non ho nulla da nascondere, eccovi la skill di cui parlo: SKILL.md. Questa fa riferimento a una serie di regole scritte qui: carousel-rules.md. ↩
-
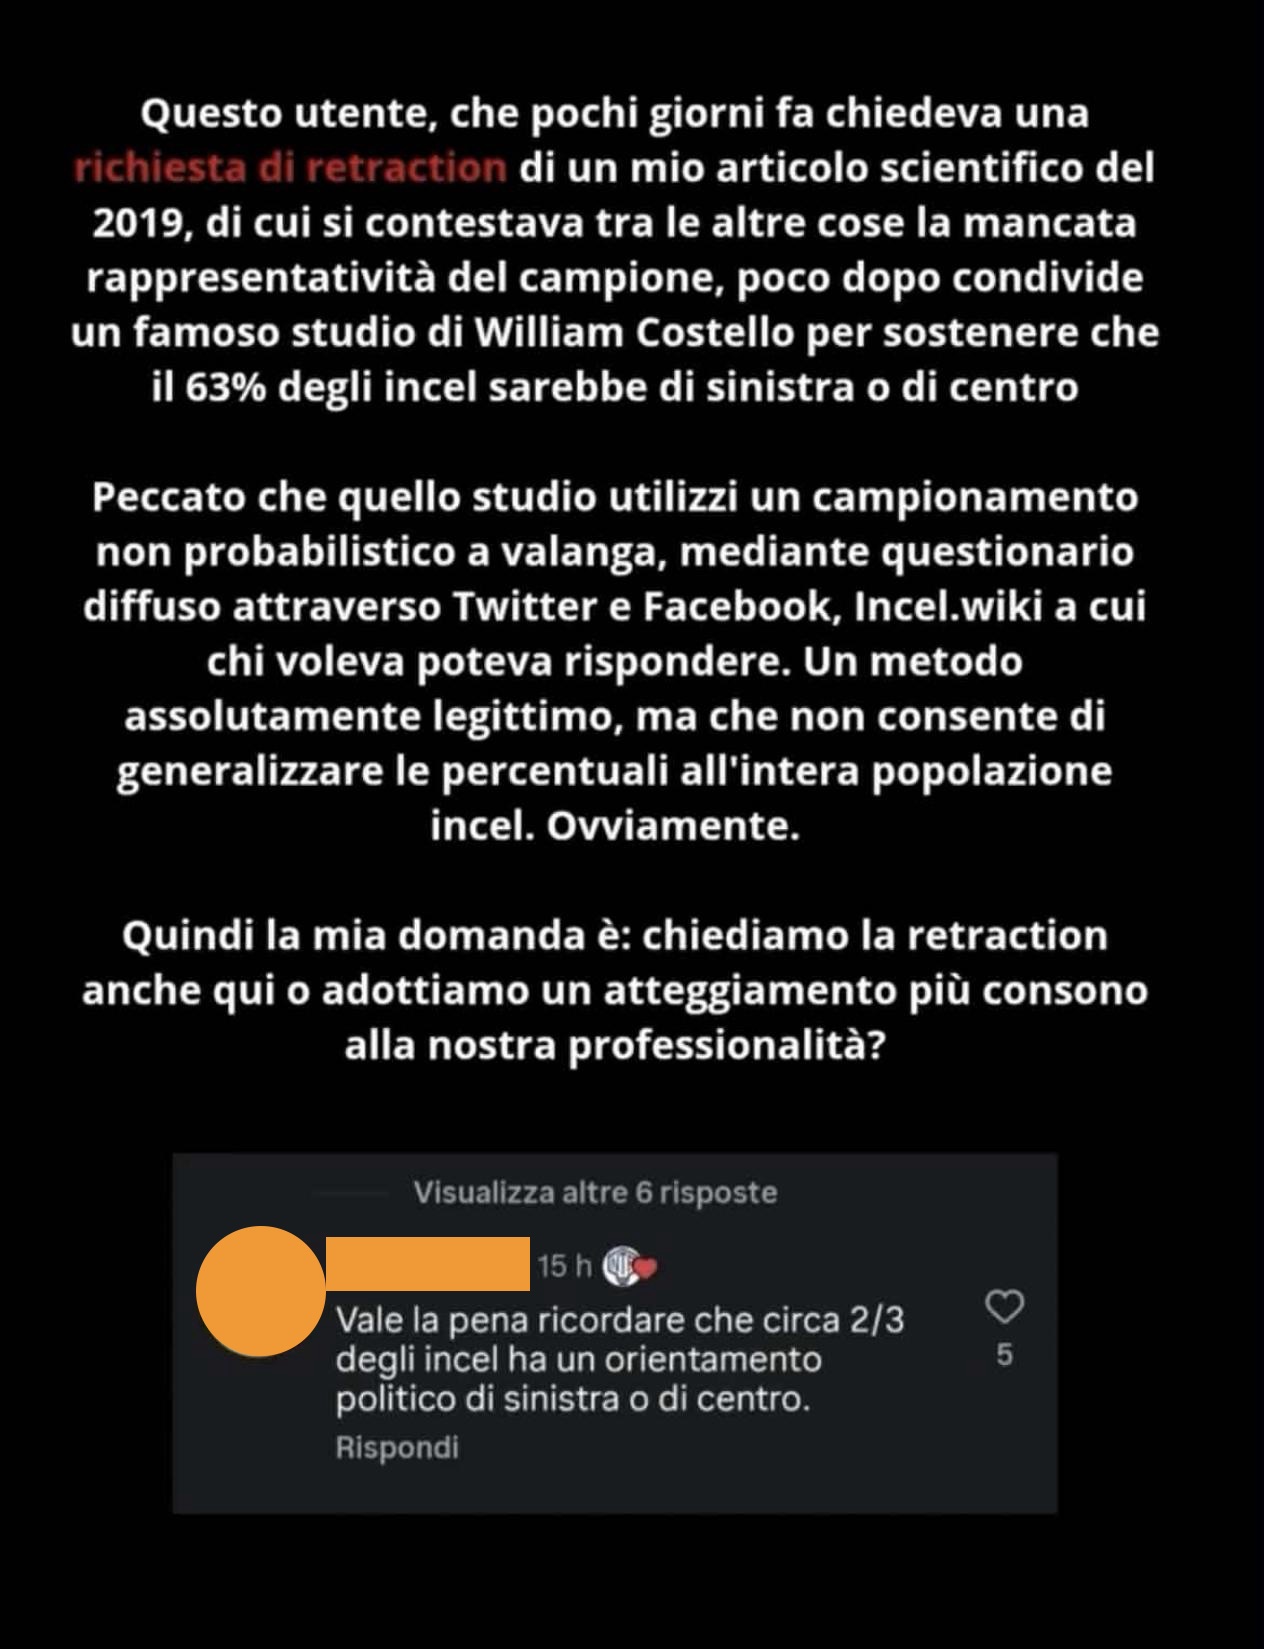
Premettendo che non ho letto nessun lavoro di William Costello se non di sfuggita, nel merito della questione tirata in ballo, io semplicemente direi questo: lo studio di cui si parla ha sostenuto di voler analizzare l’intera popolazione degli incel a partire da un campione, stando alla story, non rappresentativo? Oppure ha onestamente dichiarato i limiti di tale questionario, ad esempio riguardo all’auto-selezione del campione? Nel primo caso, personalmente non avrei nessun problema a contattare la rivista che ha pubblicato lo studio, segnalandone la possibile criticità (senza tuttavia partire in quarta chiedendo una retraction, naturalmente). Nel secondo caso, invece, il lavoro dello studio sarebbe corretto in quanto i limiti sono stati segnalati con trasparenza.
La differenza fondamentale, mi pare, è che [Farci e Righetti 2019] ha fatto la prima cosa (generalizzare i risultati a tutto il movimento) e non la seconda (dichiararne con chiarezza i limiti).
Il paper, è vero, si presenta come esplorativo («This study is aimed at exploring the Italian MRA network on Facebook»); ma dichiarare un obiettivo esplorativo non equivale a dichiarare i limiti dello studio, e soprattutto non si concilia con conclusioni come «the Italian Facebook men’s rights movement» o i «due trend dominanti nella rete MRA italiana». ↩